Файл с правилами обхода — первое, что запрашивают поисковые роботы, попадая на сайт. Настроить его можно за полчаса, но если ошибиться в одной букве — потеряете трафик, который долго привлекали.
В статье разберем, как настроить robots.txt с нуля: куда положить файл, какие директивы он понимает и чем требования Яндекса отличаются от требований Google. А также покажем два готовых шаблона: универсальный и отдельный для интернет-магазина на 1С-Битрикс.
Что такое robots.txt и зачем он нужен сайту
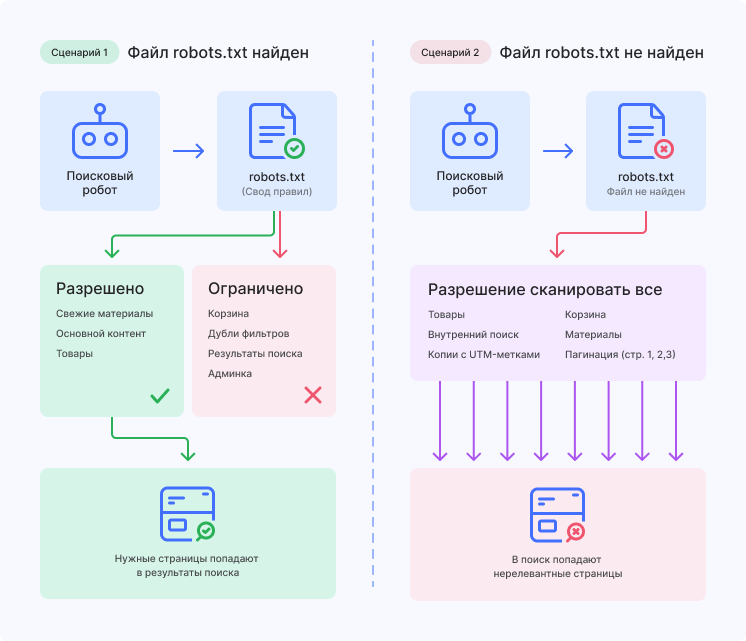
Это текстовый документ в корневом каталоге сайта: владелец перечисляет в нем поисковым системам, какие разделы сканировать можно, а какие — нет. Робот видит свод правил и понимает, где ему нужно пройтись.
Важный нюанс: файл управляет обходом, но не убирает страницу из выдачи. Если на закрытую страницу ведут ссылки с других сайтов, она может остаться в поиске — с пометкой «описание недоступно». Убрать страницу наверняка умеет только мета-тег robots со значением noindex или пароль на разделе.
Польза от файла — в экономии бюджета обхода. За один визит робот запрашивает ограниченное число страниц. Когда лимит уходит на корзины, поиск и дубли фильтров, свежие материалы и товары добираются до выдачи с опозданием. Как устроено поисковое продвижение в целом, мы разбирали в материале про SEO для начинающих.
Что произойдет, если файла нет вообще
Для небольшого одностраничного сайта — ничего страшного. Робот получает 404, трактует это как разрешение сканировать все, и сайт спокойно индексируется.
Другое дело — крупные проекты. Без правил индексация страниц идет хаотично: в выдачу затягиваются внутренний поиск, корзина, пагинация, копии адресов с рекламными метками. Магазину с десятками тысяч URL это грозит мусором в индексе: до новых карточек товаров робот добирается неделями.
Итог простой: небольшому сайту файл нужен для порядка, а крупному магазину без него не обойтись — мусор в индексе будет расти вместе с каталогом.
Где находится и как создать файл robots.txt
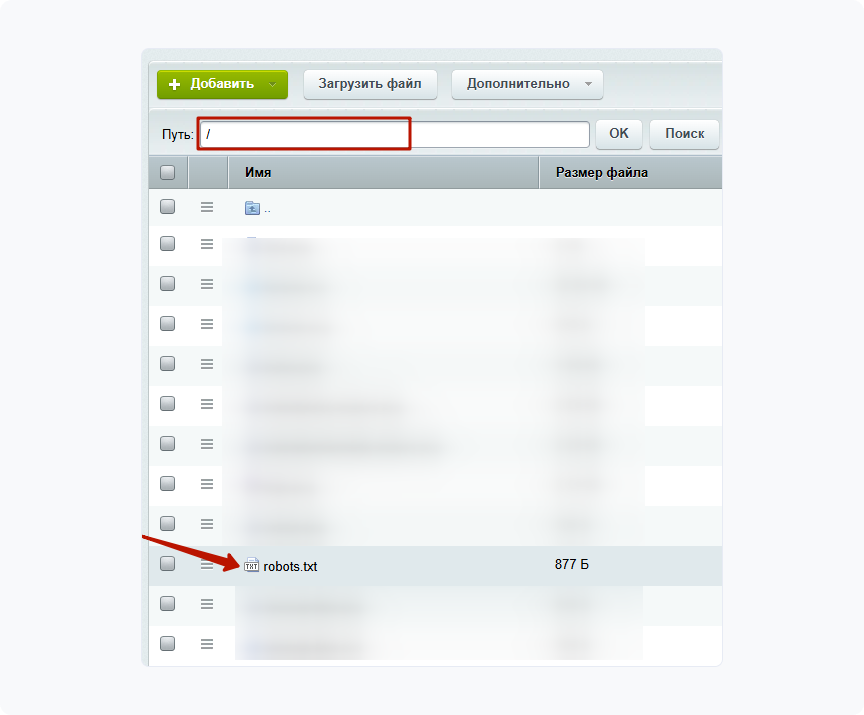
Частый вопрос про robots.txt: где находится файл? Только в корневом каталоге домена, рядом с главной страницей. Ни в папке, ни на внутренней странице — поисковые роботы туда не заглядывают.
Требования к расположению и формату файла
Требований немного, но каждое влияет на то, увидит ли робот ваши правила:
- Имя — строго robots.txt, только строчными буквами: вариант с заглавными робот не распознает.
- Кодировка UTF-8.
- Содержимое — чистый текст, без форматирования из Word и других редакторов.
- Открывается по HTTPS без пароля; сервер отдает файл без сбоев.
- На каждом поддомене — собственный набор правил: shop.vash-magazin.ru и vash-magazin.ru друг другу не подчиняются.
Google ограничивает размер: робот прочитает первые 500 КБ, остальное отбросит. Лимит не проблема, если не выписывать адреса поштучно до тысячи строк — для массовых совпадений есть спецсимволы, о них ниже.
Как создать файл вручную или через автогенерацию в CMS
До того как решать, как создать robots.txt, ответьте себе: что именно надо спрятать. Это может быть панель администратора, корзина, поиск, адреса с параметрами. Важно, что в первую очередь составляем список страниц, а уже вторую создаем файл. Иначе настройка превращается в перенос чужого шаблона вместе с ошибками.
Ручной путь:
- Откройте Блокнот, Notepad++ или VS Code.
- Перенесите директивы по правилам из раздела ниже.
- Сохраните документ с нужным именем в UTF-8.
- Залейте его в корень сайта — файловым менеджером хостинга, по FTP или через SSH.
- Загляните на адрес файла в браузере и проверьте, что тот открывается.
Быстрее — автогенерация. Например, готовые решения Аспро собирают файл сами при установке: система знает, какие служебные разделы прятать, а владелец правит готовый набор правил в административной панели. Механика описана в инструкции по автогенерации файла. При таком варианте готовый файл robots.txt для сайта собирается за пару минут — без FTP и текстового редактора.
Из каких директив состоит файл
Файл строится из директив: каждая строка — отдельная команда роботу. Разберем основные, потом дополнительные.
User-agent, Disallow и Allow — основной синтаксис
Правила robots.txt держатся на трех основных директивах. Разберем их на живой задаче: спрятать от робота весь каталог, но сохранить в нем путь к акциям.
User-agent открывает каждый блок правил и выбирает робота, которому этот блок адресован. У каждого робота свое имя — например, Yandex у Яндекса или Googlebot у Google. Если написать звездочку, правила получат сразу все роботы — так пишут чаще всего.
Disallow запрещает обход пути. Allow работает как исключение из запрета: пара строк Disallow: /catalog/ и Allow: /catalog/sale/ прячет каталог целиком, но оставляет роботу путь к акциям.
Как записывать правила, чтобы роботы поняли их правильно:
- путь начинается от корня: /catalog/, не vash-magazin.ru/catalog/;
- регистр имеет значение: /Catalog/ робот не примет за /catalog/ — это два разных адреса;
- звездочка * заменяет любую цепочку символов, $ фиксирует конец строки;
- пустой Disallow без значения значит «все разрешено» — коварная строка, вернемся к ней среди ошибок.
Порядок строк решает. Когда разрешение и запрет спорят за один адрес, Яндекс берет первую подходящую директиву по порядку, Google — правило с самым длинным совпадением пути. Спорные конструкции пишите так, чтобы оба прочитали одинаково: Allow ставьте перед Disallow.
Под разные поисковые системы закладывают отдельные блоки — каждый открывается своей строкой обращения. Робот ищет блок со своим именем; блок со звездочкой получают те, у кого персонального блока нет. Так раскладывают правила, когда роботу Яндекса нужны особые указания, а остальным хватает общих. Объединить несколько роботов в одной строке через запятую стандарт запрещает: одно имя или звездочка — на блок.
С 2022 года синтаксис закреплен открытым стандартом RFC 9309, и обе системы ему следуют. Поэтому базовый набор директив читается одинаково, а тонкости остаются надстройками конкретных поисковиков.
Директива Sitemap и другие дополнительные указания
Sitemap в robots.txt показывает роботу, где лежит карта сайта:
Sitemap: https://vash-magazin.ru/sitemap.xmlСтрока не обязательна, но полезна: свежие и обновленные страницы попадают в поле зрения робота быстрее. Карт допускается несколько — каждая своей строкой.
Есть и другие директивы, но они нишевые:
- Crawl-delay — задает паузу между запросами робота; Google никогда ее не поддерживал, Яндекс больше не учитывает;
- Host — раньше задавала главное зеркало сайта; Яндекс отменил поддержку, Google эту директиву не знал совсем;
- Clean-param — перечисляет параметры адреса, которые не меняют содержимое страницы; благодаря ей робот Яндекса не таскает дубли вроде /catalog/?ref=mail.
Host и Clean-param — расширения Яндекса, в общем стандарте их нет, Google обе пропускает. Получается, что сегодня на практике полезна только Clean-param, и только если вы продвигаетесь в Яндексе.
Вот чем различается поведение двух поисковых систем.
|
Что сравниваем |
Яндекс |
|
|
Спор Allow против Disallow |
Побеждает первая подходящая строка по порядку |
Побеждает правило с самым длинным путем |
|
Clean-param |
Работает: убирает дубли с get-параметрами |
Не поддерживается |
|
Лимит размера |
Не заявлен |
Робот читает первые 500 КБ |
Пример правильного robots.txt
Чтобы понять, как настроить robots.txt под свой проект, начните не с директив, а с ревизии: перечислите служебные разделы и адреса с параметрами, затем переносите их в файл.
Первый пример robots.txt — базовый каркас для корпоративного сайта или блога:
User-agent: *              # инструкция действует на всех роботов сразу
Disallow: /admin/          # вход в админку
Disallow: /search/         # поиск по сайту
Disallow: /*?utm_          # адреса, размеченные для рекламы
Disallow: /*?replytocom=   # технические ссылки из комментариев

Sitemap: https://vash-magazin.ru/sitemap.xml
Файл прячет админку, поиск и адреса с метками. Строка Disallow: /*?utm_ отрезает любые адреса с utm-меткой: в выдаче они плодят копии одной и той же страницы.
Интернет-магазину на 1С-Битрикс каркас нужен шире: каталог плодит дубли сортировок, видов отображения и служебных разделов.
User-agent: *              # инструкция действует на всех роботов сразу
Allow: /bitrix/js/         # js оставляем: нужны для отрисовки
Allow: /bitrix/css/        # css оставляем: нужны для отрисовки
Disallow: /bitrix/         # служебное ядро Битрикса
Disallow: /auth/           # вход в аккаунт
Disallow: /personal/       # кабинет покупателя
Disallow: /cart/           # корзина и оформление
Disallow: /search/         # поиск по товарам
Disallow: /*?sort=         # копии страниц сортировки
Disallow: /*&sort=
Disallow: /*?display=      # копии видов списка
Disallow: /*?q=            # копии результатов поиска
Disallow: /*?utm_          # адреса с utm

Sitemap: https://vash-magazin.ru/sitemap.xml
Логика шаблона. Папку /bitrix/ прячем целиком — это ядро системы, роботу там нечего смотреть. Но двумя строками выше мы открыли /bitrix/js/ и /bitrix/css/: без скриптов и стилей Google не отрисует страницу и не поймет, как она выглядит. Дальше идут служебные разделы /auth/, /personal/, /cart/ — пользы от них в выдаче ноль. Правила с sort, display и q отсекают копии, которые разводят фильтры, сортировки и поиск.
Перед выкладкой замените домен из примера на свой в строке Sitemap. И относитесь к шаблону как к каркасу, а не идеальной формуле: правильный robots.txt повторяет структуру конкретного сайта — есть форум, кабинет или галерея с параметрами, дописывайте запреты по той же логике.
Частые ошибки в файле
Проблемы с файлом рождаются не из-за незнания синтаксиса, а по невнимательности: правила переносят со старого сервера, копируют у соседей по выдаче, пишут наспех перед запуском. Правильный robots.txt получается не с первой попытки — поэтому разберем типовые ошибки и цену каждой.
Как случайно закрыть весь сайт от индексации
Дороже всех обходится одна строка: Disallow: /
Слэш после двоеточия — корень, а корень это весь сайт. Классика жанра: проект собирали на тестовом домене и закрыли его от индексации целиком, а при переезде на боевой правило заменить забыли. Индексация страниц встает, через 2–3 недели адреса сыплются из выдачи, трафик уходит в ноль. Владелец тем временем проверяет контент и ссылки — а причина сидит в единственной строке.
Зеркальный случай — Disallow без двоеточия или с лишним пробелом перед ним. Строку робот не распознает, правило игнорирует и сканирует то, что вы прятали. Для магазина это возврат дублей фильтров в индекс.
Третья история — файл лежит не в корне, а в глубине папок, или получил двойное расширение после сохранения в Блокноте. Робот его не находит и решает, что ограничений нет.
Синтаксические ошибки и забытые директивы
Что еще находят наши аудиторы в файлах клиентов:
- опечатки в директивах — Dissalow, Desallow: строка мертва, правило не работает;
- кириллические буквы, неотличимые от латинских, внутри путей;
- потерянная строка Sitemap: робот дольше находит обновления;
- комментарий без решетки #: текст ломает правило ниже;
- пустая строка посреди блока: все, что после нее, робот относит уже к другому роботу.
История из практики. В Аспро пришел интернет-магазин комплектующих для 3D-принтеров: органический трафик падал несколько месяцев, заказы таяли. Технический аудит показал в том числе недоступную карту сайта и неверно настроенный файл — роботы не видели новые страницы и расходовали обход на мусорные адреса. Правку этих файлов включили в первый этап работ. Через 7 месяцев поисковый трафик вырос с 6 500 до 13 000 визитов, заказов стало в 4 раза больше. Сам по себе файл рост не обеспечил — но без технической базы остальные улучшения не раскрываются.
Как проверить robots.txt на ошибки
Правильный robots.txt сам не рождается — без проверки не обойтись. Каждая проверка после правки дешевле разбора последствий: страницы, выпавшие из индекса, возвращаются в выдачу неделями. Хватит двух инструментов — по одному от каждой поисковой системы.
Инструменты Яндекс Вебмастера и Google Search Console
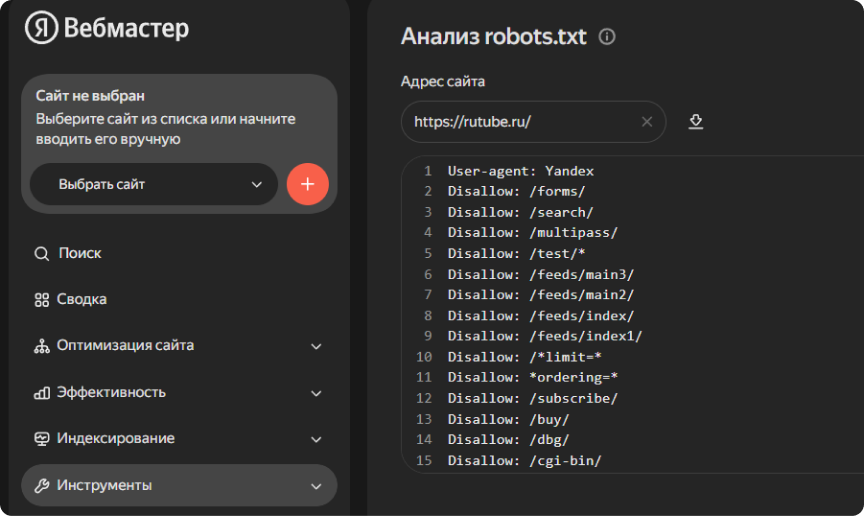
У Яндекса в панели вебмастера есть встроенный анализатор: он показывает, как робот видит файл, и прогоняет любой адрес — открыт или закрыт. Порядок такой: правка внесена, прогоняете через анализатор 5–10 значимых адресов — главная, категория, карточка товара, корзина, — и сверяете результат с замыслом.
В Search Console отдельного анализатора нет: статус файла виден в отчете «Индексирование страниц», а заблокированные адреса перечислены в отчете «Страницы» с пометкой о блокировке файлом. Заметили там нужные страницы — пересматривайте правила.
Помните про кэш: поисковые системы держат копию файла, у Google — до суток. Внесли правки — возвращайтесь к отчетам через день-два, не раньше.
Как часто перепроверять файл. По плану — раз в квартал. Вне плана — после каждого релиза и перестройки структуры, после смены CMS или переезда на новый домен, после старта рекламных кампаний с метками: именно метки ссылок чаще всего разводят потоки дублей.
Файл robots.txt для сайта — живой документ: структура выросла — правила пересмотрели, а не оставили как написали однажды.
Итог
Мы разобрали правила директив, два шаблона под разные проекты и инструменты контроля. Это настройка за полчаса — с дорогой ценой ошибки: трафик падает тихо, без предупреждений. Разбираетесь в структуре сайта — соберите файл по шаблонам выше и прогоните через анализатор, как это сработало в кейсе магазина 3D-принтеров.
Нужна помощь в проверке файла и поиске ошибок — SEO-аудит сайта: проверим файл и остальную техническую часть, покажем, что мешает росту. А если вы только запустили сайт, начните с базовой поисковой оптимизации — в ней настраиваем все необходимое для корректной индексации страниц.